自然言語処理 システム開発【2026年版】生成AI時代の導入判断
はじめに
自然言語処理は、問い合わせ文、議事録、レビュー、社内文書、メールなど、人が普段使う言葉をシステムで扱うための技術です。生成AIが広がったことで「文章を読ませれば何でもできる」と見えやすくなりましたが、実際の業務システムでは、どの文章を入力し、どの処理を自動化し、どこで人が確認するかを決める設計が欠かせません。
特に問い合わせ分類、社内ナレッジ検索、議事録要約、チャットボット、VOC分析では、AIの回答そのものよりも、元データの整理、権限管理、ログ、評価、既存システムとの接続が成果を左右します。自然言語処理 システム開発は、単にAI APIを呼び出す作業ではなく、業務フローを言葉のデータ中心に組み直す取り組みです。
また、2026年時点では、従来型のNLP、生成AI、RAG、ノーコードツールを組み合わせる選択肢が増えています。だからこそ、最初に「何を自動化するか」を絞ることが重要です。
先に判断軸を持っておくと、過剰なAI導入や、現場で使われない試作を避け、安全に進めやすくなります。
この段階で目的と制約を分けておくと、NLP、LLM、RAGのどれを使うべきかも判断しやすくなります。
この記事では、自然言語処理でできること、従来型NLPと生成AI/LLMの違い、RAGやチャットボットへの組み込み方、導入前の注意点を整理します。BubbleやDifyなどのノーコードを使って小さく検証する方法も含めて、開発前の判断に使える形で解説します。
自然言語処理システム開発でできること
自然言語処理で最初に考えるべきことは、「文章を何に変換したいか」です。Google Cloud Natural Language APIの公式ドキュメントでは、感情分析、エンティティ分析、エンティティ感情分析、構文解析、コンテンツ分類などが整理されています(出典: Google Cloud Natural Language API)。Azure Languageでも、PII検出、言語検出、NER、キーフレーズ抽出、質問応答、感情分析、要約、分類などが提供されています(出典: Microsoft Learn Azure Language)。
業務システムに落とし込む場合は、機能名ではなく業務上の出力で考えると失敗しにくくなります。
| 目的 | 使う処理 | 業務システムでの使い方 |
|---|---|---|
| 問い合わせを振り分ける | 分類、意図判定 | 担当部署、緊急度、対応ステータスを自動付与 |
| 重要情報を抜き出す | エンティティ抽出、NER | 顧客名、商品名、日付、金額、契約番号を抽出 |
| 顧客の声を読む | 感情分析、キーフレーズ抽出 | レビューやアンケートから不満点を整理 |
| 長文を短くする | 要約 | 議事録、報告書、サポート履歴を確認しやすくする |
| 社内文書を探す | 検索、RAG | FAQ、規程、提案書を根拠付きで参照する |
たとえばサポート窓口では、フォームやメールの内容を受け取り、AIでカテゴリと緊急度を付け、担当者が確認して返信する流れを作れます。ここで大事なのは、AIの分類結果をそのまま顧客に返さないことです。分類結果、根拠文、担当者の修正履歴を残す設計にすると、後から精度改善や運用ルールの見直しができます。
生成AI・LLM・RAGとの違いと使い分け
生成AIやLLMは自然言語処理を大きく進化させましたが、従来型NLPと同じ役割ではありません。従来型NLPは、決まった分類、抽出、スコアリングを安定して実行しやすい一方、LLMは自然な文章生成、要約、柔軟な質問応答に強みがあります。RAGは、社内文書やFAQを検索してからLLMに回答させる構成で、根拠を持たせたいチャットボットに向いています。
| 方式 | 向いている処理 | 注意点 |
|---|---|---|
| 従来型NLP | 定型分類、固有表現抽出、感情スコア | ルールやしきい値の設計が必要 |
| LLM | 要約、自然な回答文、複雑な相談対応 | 誤回答や情報漏えい対策が必要 |
| RAG | 社内文書検索、FAQ回答、規程参照 | 文書整備、権限、検索品質が重要 |
| 人の確認 | 顧客送信、契約判断、医療・法務系判断 | 確認画面と承認ログが必要 |
問い合わせを「請求」「不具合」「契約変更」に分類するだけなら、従来型NLPや軽量な分類モデルで十分な場合があります。一方、問い合わせ内容を読み、社内FAQから根拠を探し、丁寧な返信案まで作るなら、RAGとLLMを組み合わせる価値があります。AIに任せる範囲と人が責任を持つ範囲を分けることが、生成AI時代のシステム開発では重要です。
BubbleとDifyを組み合わせる構成は、こうした検証に向いています。画面や顧客管理はBubbleで作り、プロンプト、RAG、チャットフローはDify側で管理できます。具体的な考え方はBubble×Difyを組み合わせる理由でも整理しています。
業務システムでの活用事例
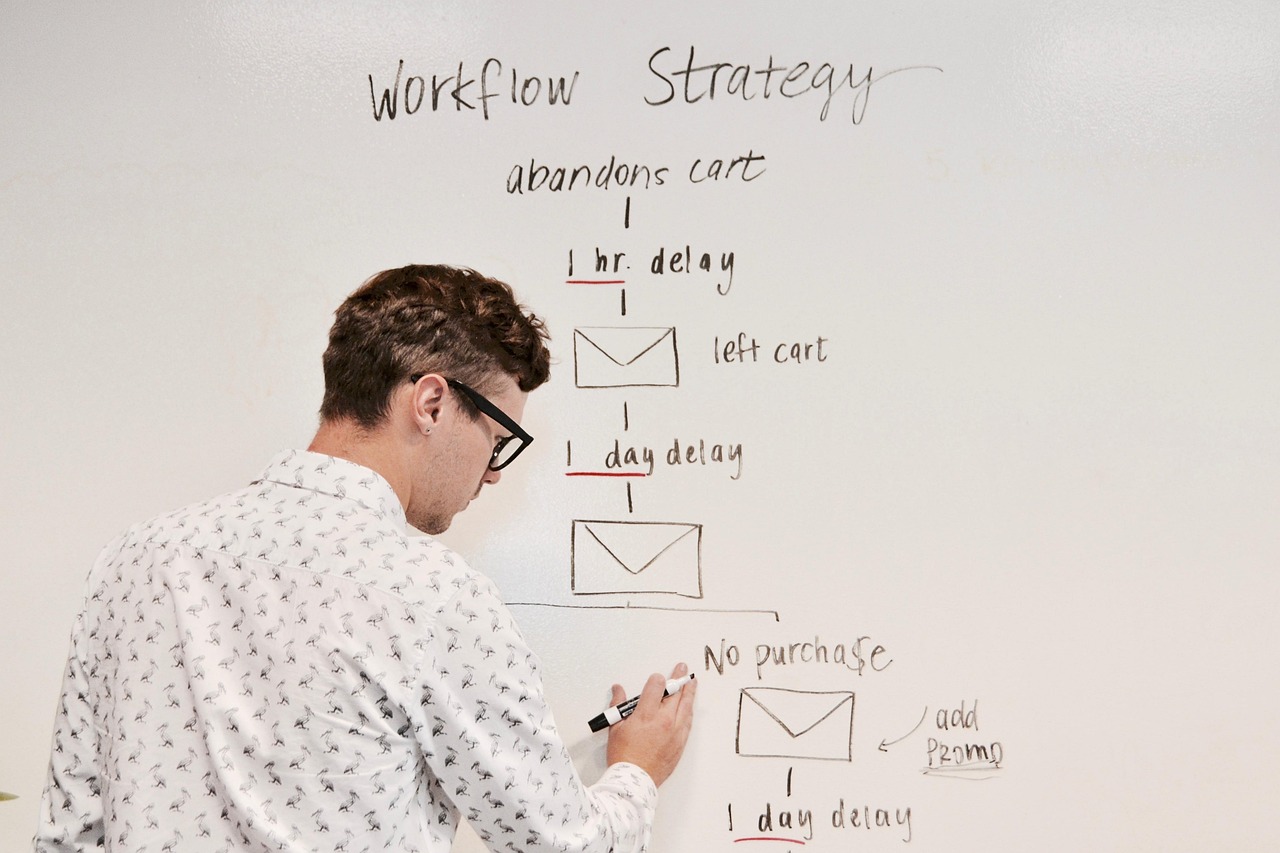
自然言語処理は、文章が大量に発生し、人の確認に時間がかかっている業務ほど効果を出しやすいです。よくある例は、問い合わせ管理、社内ナレッジ検索、議事録要約、レビュー分析です。
ケースとして、BtoB企業のサポート窓口を考えます。メール、フォーム、チャットから届く問い合わせを1つの管理画面に集約し、AIがカテゴリ、緊急度、関連FAQ、返信案を表示します。担当者は回答案を確認し、必要に応じて修正して送信します。返信後は、カテゴリ、対応時間、修正内容を保存し、FAQやプロンプトを改善します。
この構成では、AIは担当者を置き換えず、情報整理と下書きを担います。管理者は問い合わせ傾向を見て、プロダクト改善やFAQ更新につなげられます。自然言語処理を業務改善につなげるには、入力から改善までのループを作ることが重要です。
議事録要約でも同じです。要点、決定事項、担当者、期限を抽出し、重要な約束だけ人が確認します。社内ナレッジ検索では、部署や権限ごとに参照範囲を分け、根拠URLや更新日を画面に出します。
導入前の注意点とノーコードで小さく始める方法
自然言語処理システムには、便利さと同時にリスクもあります。入力文に個人情報や機密情報が含まれる場合、外部APIへ送る範囲、ログ保存、学習利用の扱いを確認する必要があります。Azure Languageの公式情報でも、PII検出やデータ保護に関する機能が整理されています。
まず1つの業務に絞り、正解データ、評価基準、承認フローを決めてPoCを行う方が現実的です。
| 課題 | 失敗しやすい進め方 | nocoderiでの解決策 |
|---|---|---|
| 精度が読めない | いきなり全社導入する | Bubbleで確認画面を作り、少量データで検証する |
| 誤回答が怖い | AI回答を自動送信する | Difyで回答案まで作り、人の承認を必須にする |
| 情報漏えいが心配 | 入力データを整理せずAPIへ送る | PII検出、マスキング、権限分離を設計する |
| 改善できない | ログを残さない | 修正履歴、評価、プロンプト更新を管理する |
ノーコードで始める場合は、入力フォーム、管理画面、AI処理、確認、ログ保存を小さくつなぐ構成が扱いやすいです。Bubbleで問い合わせ一覧と承認画面を作り、DifyやAPIで分類、要約、返信案生成を行い、最終送信は担当者が確認します。小さく作って実データで検証し、精度と運用負荷を見てから拡張することが、NLP導入の現実的な進め方です。
まとめ
自然言語処理は、文章を分類、抽出、要約、検索、分析し、業務システムで扱いやすいデータに変える技術です。生成AIやLLMによってできることは広がりましたが、業務で使うには、入力データ、権限、根拠、確認、ログ、評価を設計する必要があります。自然な回答を作るだけではなく、どの作業を短縮し、どの判断を人に残すかを決めることが重要です。
問い合わせ分類、社内ナレッジ検索、チャットボット、議事録要約、レビュー分析は、自然言語処理を導入しやすい領域です。従来型NLPで安定した分類や抽出を行い、LLMで要約や回答案を作り、RAGで社内文書を参照させると、現場で使える仕組みに近づきます。ただし、個人情報、機密情報、誤回答、権限管理を軽く扱うと、運用で止まりやすくなります。
まずは1つの業務に絞り、BubbleやDify、AI APIを組み合わせてMVPを作るのがおすすめです。確認画面とログを残せば、AIの精度だけでなく、担当者の修正内容や業務時間の変化も見えます。自然言語処理 システム開発は、AI機能の導入ではなく、言葉で動く業務フローの再設計です。
開発会社に相談する前には、対象業務、入力データ、期待する出力、人が確認する条件を1枚にまとめておくと話が進みやすくなります。AIの種類を先に決めるより、現場で減らしたい作業と避けたいリスクを明確にする方が、必要な構成を選びやすくなります。ノーコードの試作で成果が見えた段階で、本格開発や外部連携の範囲を決める流れが現実的です。

ビジネスの課題解決をサポートします
- システム開発を短期間でコストを抑えて作りたい
- システムのDX推進を進めていきたい
- 社内の業務効率化を進めたい